谷歌放大招!Gemini 2.0横空出世,AI绘图+视频制作一键搞定!
昨天凌晨,Google的原生多模态生图功能 Gemini 2.0 上线了。
一句话概括:通过简单的一句描述,Gemini就能自动P图/画漫画/做视频分镜等。
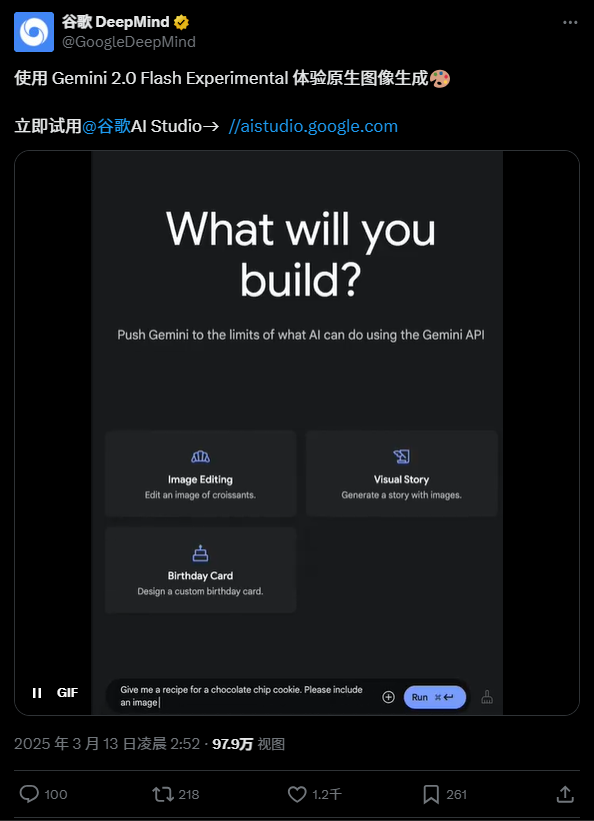
在推特上,这条阅读量妥妥的突破100万+了。
昨晚尝试了一下,效果很炸裂,给大家演示一下。
测试案例1:换衣
比如,我想给这位美女换上梅西的10号球衣。
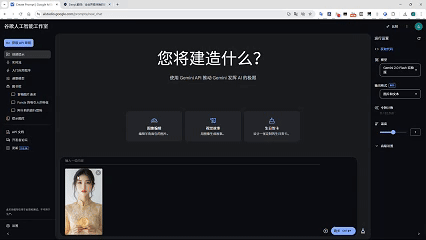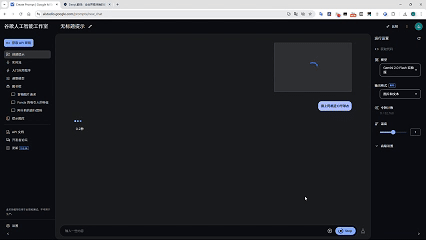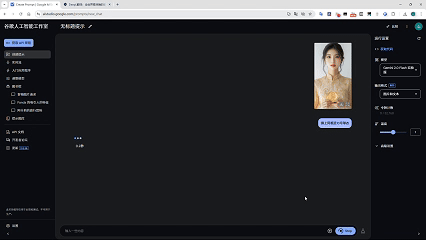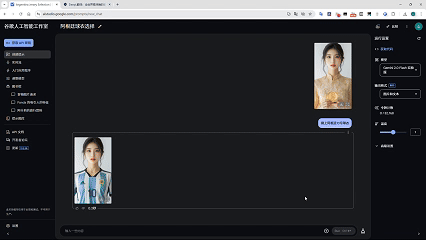
这要放在AI之前就得靠PS、然后可灵「AI试衣」提效了,但现在体验完全变了,不需要太多复杂的操作,只需要把这个需求用一句话发给Gemini就行了。
测试案例2:生成效果图
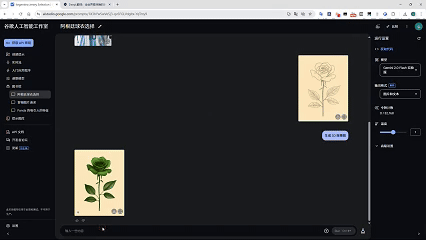
比如给Gemini一张简笔画,让它生成效果图。
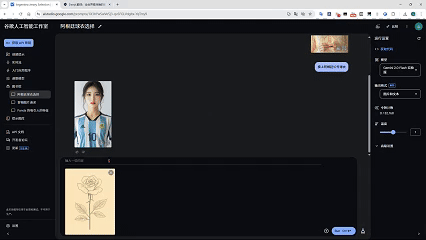
全绿了,这不是我们想要的效果,继续给它提示:花是红的,叶子是绿色。
测试案例3:背景替换
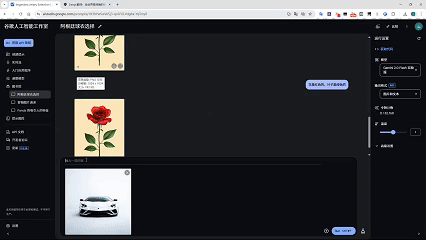
比如让Gemini帮我换一下这张汽车的背景。
测试案例4:合成
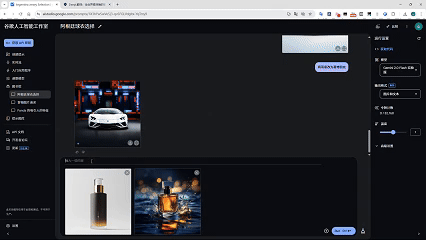
2个产品合在一起,可以实现,但离预期还有点远,也有可能是提示词的问题,可以多roll几次看看。
测试案例5:品牌广告
直接一键生成分镜+图片。
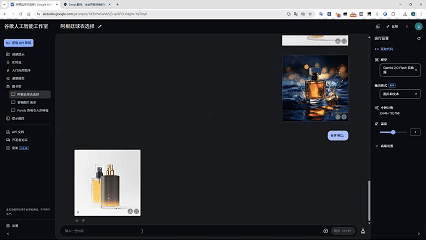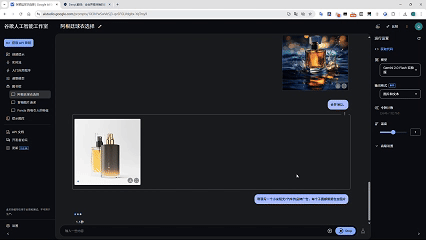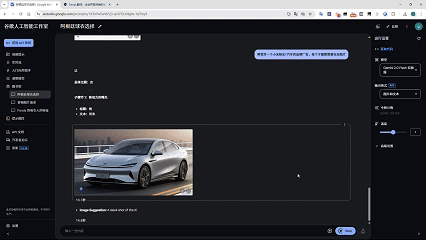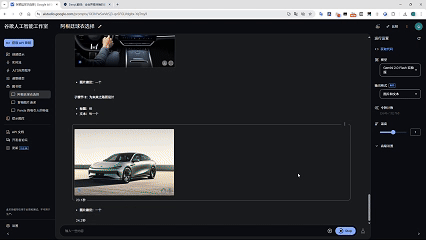
如果图片质量再迭代迭代,或许就不用什么DeepSeek+MJ这种组合拳了,直出图片转视频,然后丢到剪映一键成片。
或许再更新更新,连生视频、剪映都不用了,一个AI工具真可以直接一步到位了。
Gemini 2.0如何使用?
第一步、登录注册
浏览器输入 https://aistudio.google.com/ 进入网站登录注册。
第二步、选择模型
右侧新建对话,然后左侧模型选择 Gemini 2.0 Flash Experimental
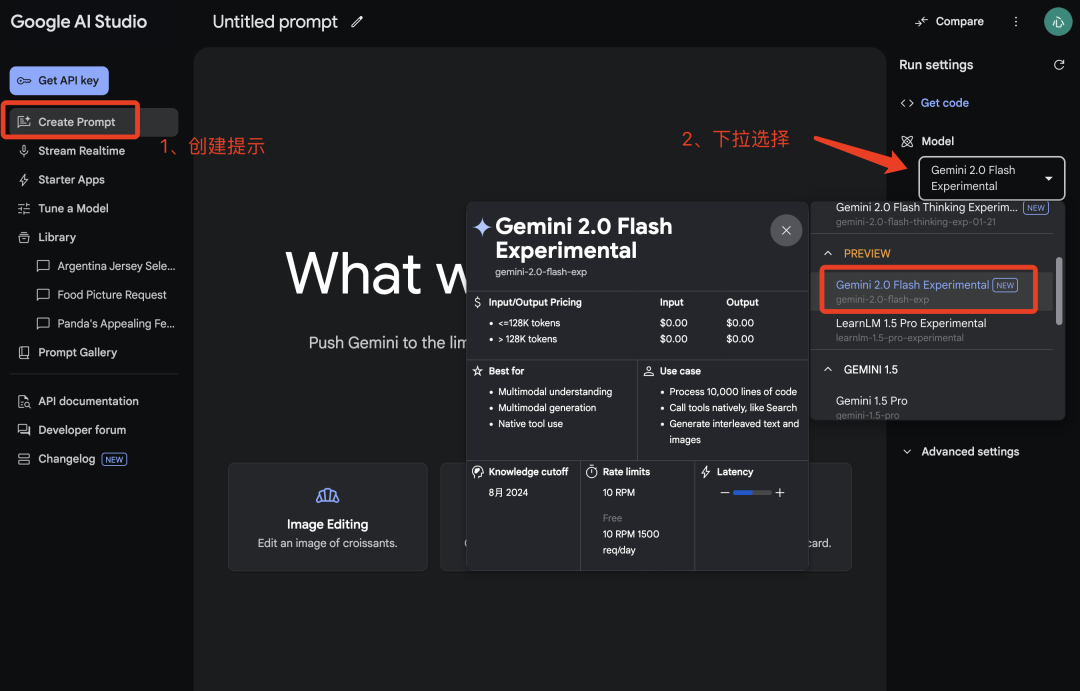
输入类型选择文字+图片。
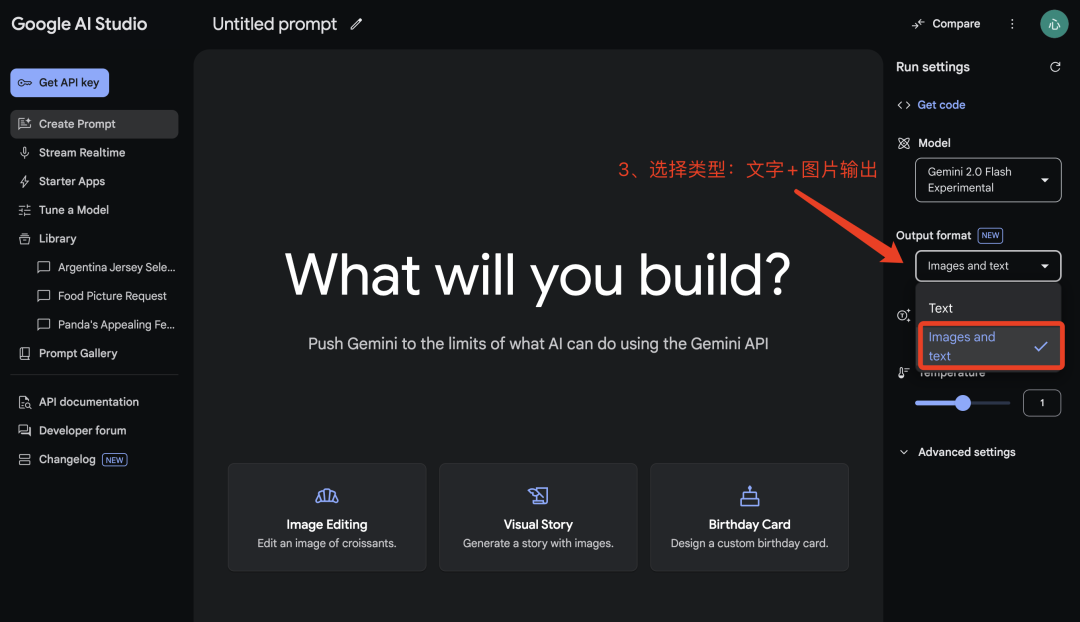
然后,就可以直接在输入框里丢你需要上传的图片和提示词了。
最后
Gemini 2.0 开启了一条AI新时代,通过简单的语言描述就可以生成和编辑图片。
再一次把使用门槛降低,效率提高了。
以后AI就是「牛马」,可以可劲的对它提需求,指哪改哪,还没有一点脾气的那种。
Gemini 2.0目前免费使用,建议大家去尝试一下。
降低预期,都是惊喜,可能还有很多问题,但并不妨碍我们看到Gemini的惊艳之处。